Wellen-Textur Teil 2: Was das Auge sieht und keine Formel findet
Die Textur aus Teil 1 messen
In Teil 1 hatte ich beschrieben, was mir an OpenAIs neuen Bildern auffiel: eine wiederkehrende Textur in Flächen, die eigentlich glatt sein sollten. Stoff, Marmor, Haut, Hintergrund. Ich sehe sie in jedem OpenAI-Bild sofort, es nervt mich. Nach dem Veröffentlichen wollte ich wissen, ob ein mathematisches Verfahren wie ein Wavelet oder eine Fourier-Transformation sie auch sichtbar macht. Also fragte ich Claude, und wir fingen an, Messverfahren durchzuprobieren.
Rund zehn Messverfahren ohne Training
Claude rechnete rund zehn Ansätze durch, die ohne Trainingsdaten auskommen.
Frequenzbasierte Verfahren zuerst: Wavelet-Statistiken, eine lokale Kurtosis-Karte, ein geweißtes Spektrum. Dann Versuche, die Form und Musterbausteine zählen: Streuung der Texturform im Bild, Sortierung in 48 Mustertypen. Dann direkte Suche nach Wiederholung: kopierte Stücke, Wellenform an Konturen, Buckelabstände. Zuletzt DINOv2 als Ähnlichkeitssuche, also ein vortrainiertes Modell, das Bilder vergleicht, aber nicht darauf trainiert wurde, OpenAI-Bilder zu erkennen.
Keiner davon trennte OpenAI-Bilder zuverlässig von anderen.
Claude erklärte das Scheitern so: Die Messungen bilden Durchschnitte über das ganze Bild und werfen dabei die Form weg; das Muster ist aber eine räumliche Eigenschaft.
Zwei Fehler fielen Claude selbst auf. Zuerst bestand die Foto-Kontrollgruppe aus Windows-Hintergrundbildern, die in Wirklichkeit 3D-Renderings waren. Dann ließen Claudes Gabor-Filter großflächige Helligkeitsverläufe durch und ergaben so eine scheinbar saubere Trennung.
Zu DINOv2 ohne Training merkte Claude an: “Das hätte ich vorher bedenken können.” DINOv2 wurde beim Training mit Unschärfe und Farbverschiebungen gestört, damit es lernt, diese zu ignorieren. Es erkennt, was etwas ist, und blendet die Machart aus.
Das Schachbrett
Beim Mitteln der Frequenzspektren fand Claude einen Nebenbefund. In den unveränderten OpenAI-Originalen sind benachbarte Pixel abwechselnd um einen winzigen Betrag heller und dunkler, wie die Felder eines Schachbretts. Mit etwa einem Zehntel Graustufe ist das viel zu schwach, um es zu sehen; erst wenn man über das ganze Bild mittelt, tritt es hervor. In allen 31 zuerst geprüften Bildern war es deutlich. Bei anderen Generatoren kaum.
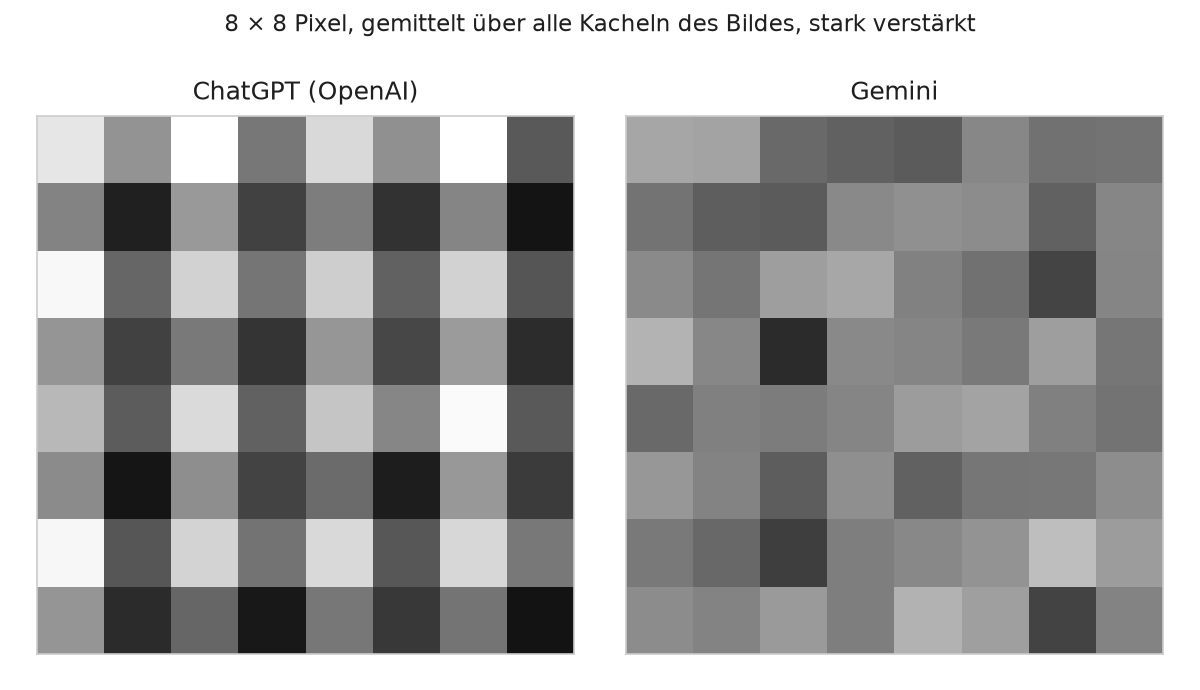
Das Schachbrett ist nicht die sichtbare Welle. Verkleinern, Screenshots und WebP mit normaler Qualität löschen es. Codex ist OpenAIs Programmier-Assistent und kann auch Bilder erzeugen. Beim späteren Codex-Lauf für Trainingsdaten fehlte das Schachbrett bei rund 30 Prozent der Originale, meist quadratischen Bildern, Logos und Typografie. Schwache Ausprägungen kommen auch bei anderen Generatoren vor, deshalb zählt im Werkzeug erst ein starkes Muster.
Claude warnte: Für einen Detektor wäre das Schachbrett eine Falle, weil er zuerst das einfachste Signal lernt und alles andere ignoriert. Ich hatte den Hinweis gegeben, dass die Textur schon seit gpt-image-2 auftritt, das OpenAI im April als ChatGPT Images 2.0 eingeführt hatte, dem Vorgänger von Flare und Sunburst aus Teil 1. Claude belegte über die C2PA-Daten, einen signierten Herkunftsnachweis in der Datei, dass die Titelbilder meiner Blogartikel ab Mai schon gpt-image-2-Bilder sind. Die Ursache des Schachbretts bleibt offen.
Ein eigenes Bildpaar
Ich legte Claude ein eigenes Bildpaar vor: denselben Prompt, einmal in ChatGPT, einmal in Gemini erzeugt. Ein Ring über einer Lavalandschaft. Im ChatGPT-Bild markierte ich viele Stellen, an denen die Textur zu sehen war, etwa eine Felskante, an der sich immer wieder ähnliche Steine wiederholten. Ich war mir nicht sicher, ob Claude das Muster überhaupt sieht und versteht, was ich meine.
Claude gab mir in zwei Punkten recht. Erstens: Es sieht Bilder verkleinert, und bei doppelter Vergrößerung erkannte es das Muster auch. Zweitens: Alle bisherigen Tests hatten Durchschnitte über ganze Bilder gebildet, aber Wiederholung ist eine Beziehung zwischen Stellen. Claude beschrieb es so: Es wiederholt sich dieselbe Sorte Element, die Pixel sind jedes Mal andere.
Der Blindtest
Claude schlug einen Blindtest vor und schrieb 20 Prompts. Ich erzeugte jeden von Hand einmal in ChatGPT und einmal in Gemini, erstes Ergebnis genommen. Claude baute eine kleine App, die Graustufen-Ausschnitte ohne Hinweis auf die Herkunft zeigte.
Runde 1 mit kleinen Ausschnitten: 72 Prozent richtig zugeordnet. Ich fand die Ausschnitte zu klein. Claude schlug eine zweite Runde mit größeren Ausschnitten aus verkleinerten Bildern vor: 89,5 Prozent. Claude: “Das Muster braucht Fläche, wie du gesagt hast.”
Claude hatte seine Vorhersagen für Runde 2 vorher festgelegt: mehr als 61 Prozent der OpenAI-Ausschnitte erkannt, insgesamt mehr als 72 Prozent richtig. Beide Vorhersagen traten ein. Der Vorbehalt: Es waren dieselben Bilder in beiden Runden, in derselben Nacht. Einen Lerneffekt kann ich nicht ausschließen.
Ein trainierter Klassifikator
DINOv2, das vortrainierte Modell aus den gescheiterten Versuchen, blieb unverändert. Claude setzte eine dünne Schicht darauf, einen linearen Klassifikator, und trainierte nur diese auf den 20 Bildpaaren: OpenAI oder nicht.
Claude hielt reihum ein Paar zurück und trainierte auf den übrigen 19: 20 von 20 Paaren richtig. Auf den Blindtest-Ausschnitten kam der Klassifikator auf 69 von 76 richtigen, ich auf 68. Gemeinsame Fehler nur zwei. Claude prüfte zusätzlich, welche Schichten des Modells das Signal tragen. Das deutete auf frühe Schichten hin, die auf die Machart eines Bildes reagieren.
Bei OpenAI-Bildern schlagen Felsen, Bergflanken, Nebelränder, Strickpullover und Marktgedränge an. Glatte Flächen bleiben neutral.
Die Grenze der Probe: Ältere Bilder, die Codex erzeugt hatte, hielt der Klassifikator für Gemini. Und 20 Paare sind wenig.
Das Werkzeug und die Heatmap
Aus dem Klassifikator wurde ein lokales Werkzeug, das als App und auf der Kommandozeile läuft. Es gibt ein Urteil in drei Stufen ab, mit einem Bereich “unklar” dazwischen, dazu eine Heatmap, eine Schachbrett-Prüfung und eine C2PA-Auswertung. Trainiert auf rund 1.350 Bildern: 275 davon OpenAI, der Rest Midjourney, Stable Diffusion, Gemini und eigene Kamerafotos.
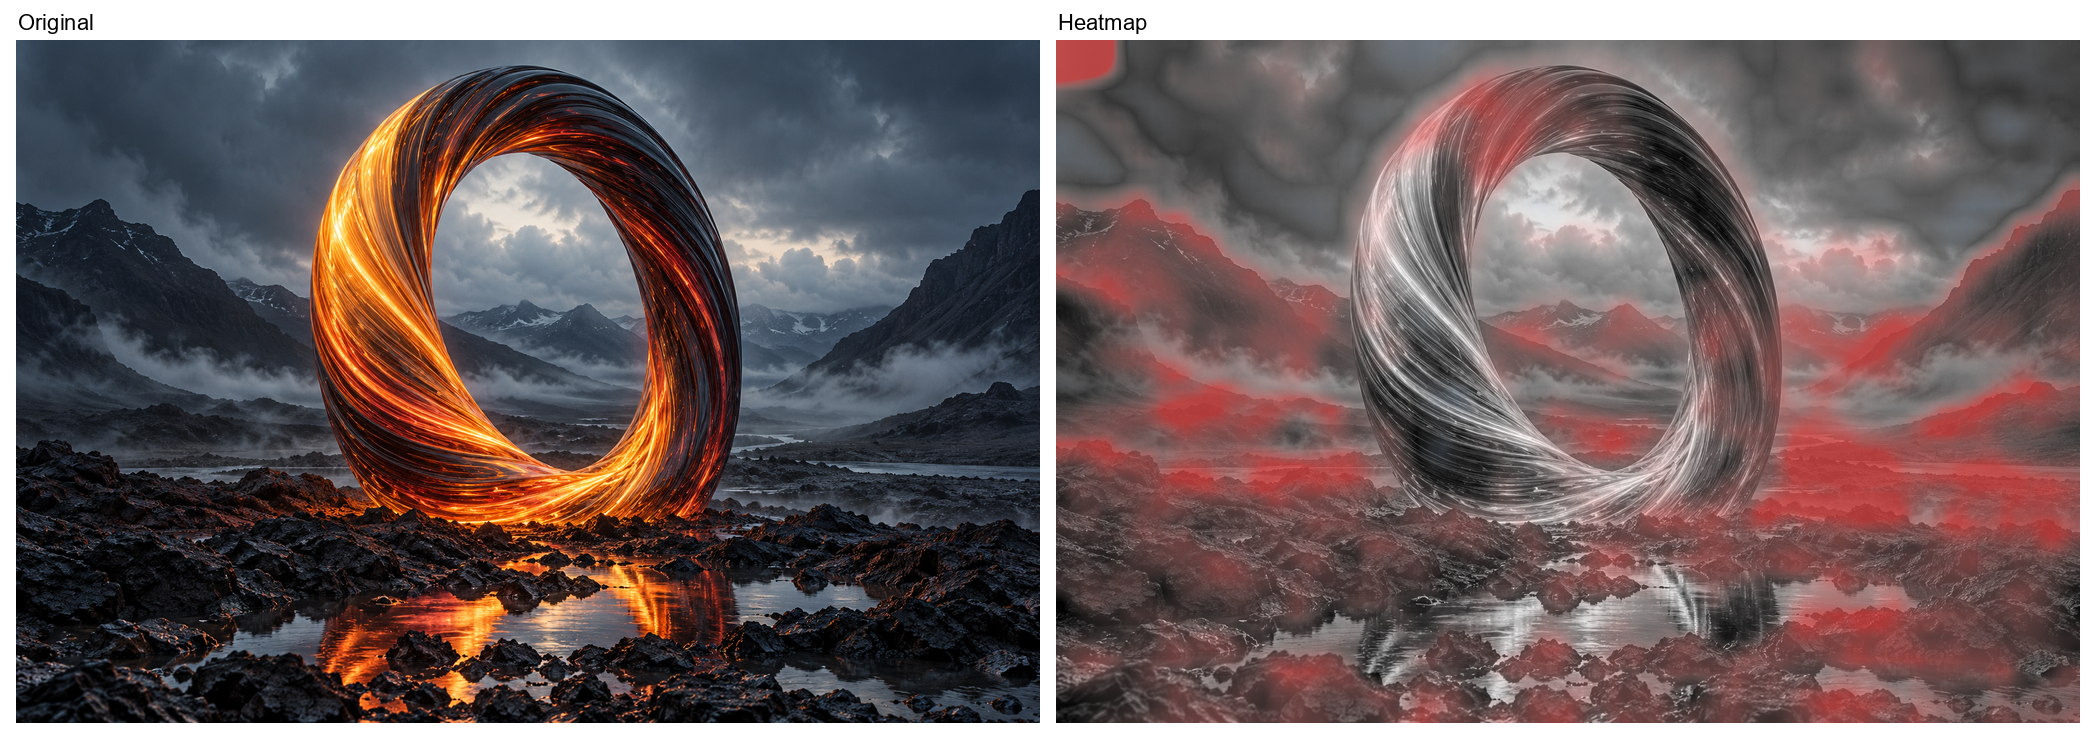
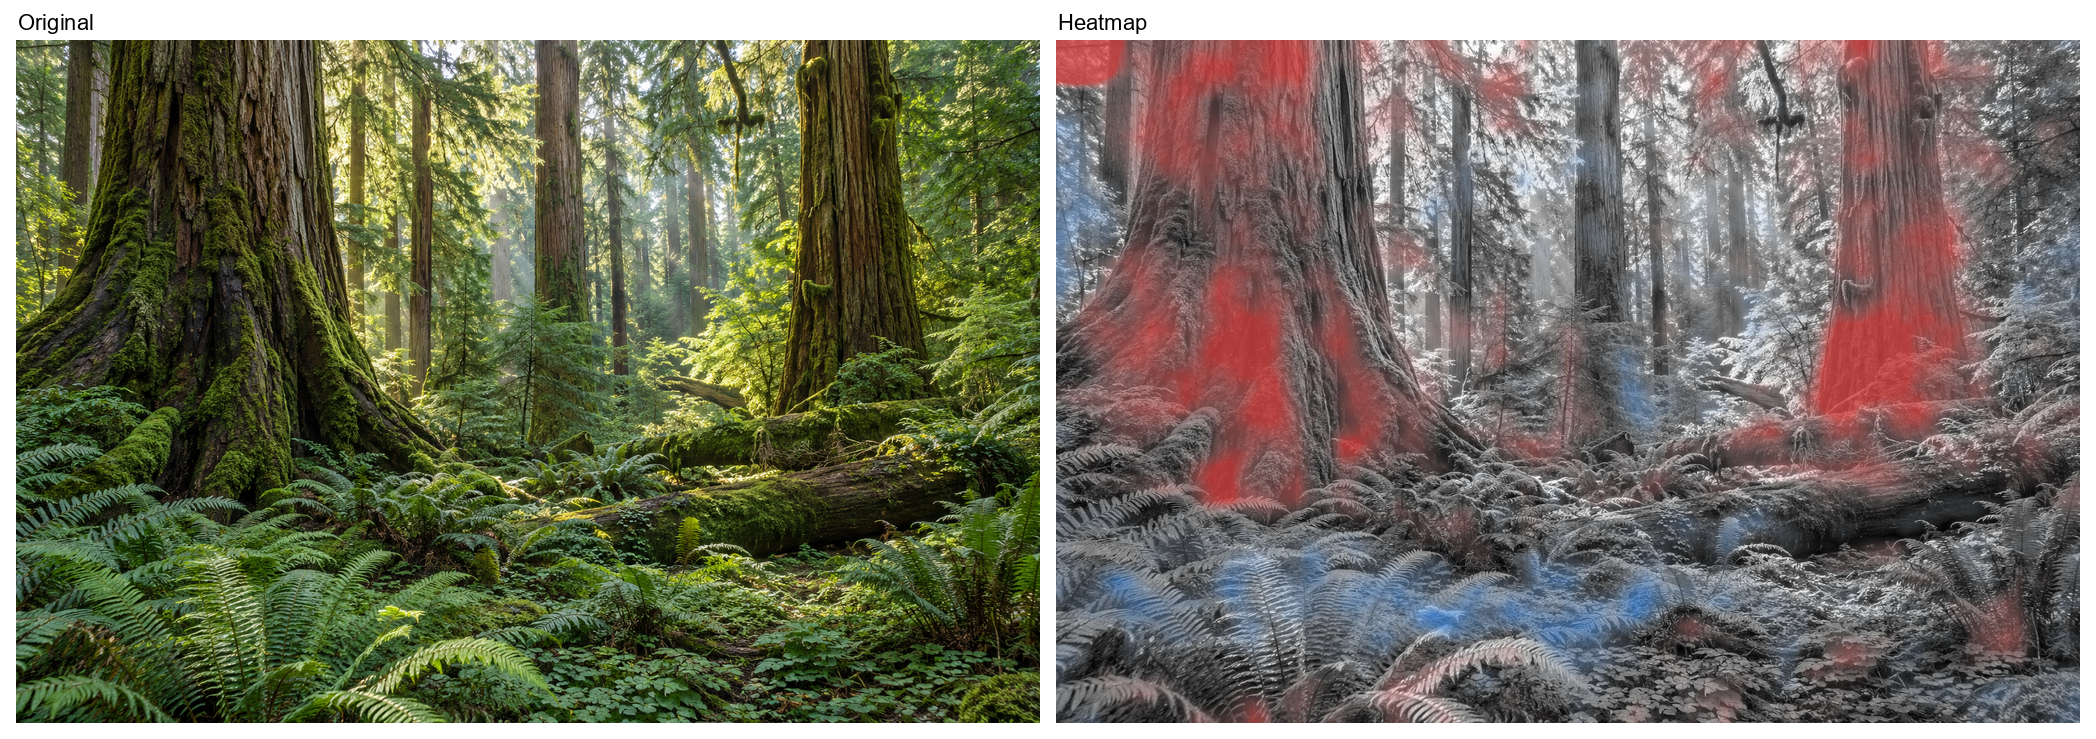
Die Heatmap zeigt nicht, wo das Muster dem Auge auffällt. Sie zeigt, wo sich OpenAI-Bilder vom Rest unterscheiden. Rot spricht für OpenAI, blau dagegen. Den Unterschied bemerkte ich, als ich ein Bild aus dem Netz durch das Werkzeug schickte, auf dem mir die Zweige auffielen. Das Werkzeug markierte sie nicht. Claude erklärte das so: Das Modell hat gelernt, welche Bildstellen bei OpenAI anders aussehen als bei allen anderen Quellen.
Beim Ring-Bild fielen Heatmap und Auge zusammen: Das Uferband, aus dem die Stellen stammten, die ich Claude am Anfang gezeigt hatte, leuchtete rot.
Beim Urwald-Bild zeigte sich eine Lücke. Die Baumstämme leuchten rot, die Farne blau, obwohl ich die Textur dort sehe. Das Werkzeug und das Auge sind sich nicht überall einig. Beide Bilder waren Teil der Trainingsdaten. Die Karten zeigen, wohin das Modell schaut; über Treffer auf neuen Bildern sagen sie nichts.
Im zurückgehaltenen Testsatz: 0,5 Prozent Fehlalarme und 97,8 Prozent erkannt. Auf 84 echten Reddit-Screenshots hielt es fast ein Viertel der Bilder anderer Generatoren für OpenAI. Das Werkzeug liefert deshalb nur einen Hinweis. Niemand soll damit beschuldigt werden.
Warum OpenAI das nicht wegtrainiert
Ich finde dieses Muster aus Wiederholungen und zu vielen Details schrecklich. Einmal gesehen, finde ich es in jedem OpenAI-Bild wieder. Viele Menschen scheinen es nicht zu sehen oder nicht sehen zu wollen. Die Bilder landen in Produkten, in Apps und auf Werbeplakaten. Das finde ich schade.
Wenn ein kleiner Klassifikator das Muster findet, könnte OpenAI einen solchen Klassifikator beim Training als Strafsignal einsetzen.
Verfahren dafür gibt es schon. Ein Bauteil von Stable Diffusion, der sogenannte Decoder, lernt mit einem eingebauten Prüfer, einem Diskriminator (Rombach et al. 2022). Neuere Verfahren schärfen Bildmodelle mit Bewertungsmodellen oder Menschenurteilen nach (ImageReward, Xu et al. 2023; Diffusion-DPO, Wallace et al. 2023; DRaFT, Clark et al. 2024).
Ein Risiko dabei: Das Modell kann lernen, einen einzelnen Bewerter auszutricksen. DRaFT dokumentiert ein verwandtes Muster als “Reward Hacking”: Das Modell kollabiert auf ein hoch bewertetes Bild. Wie leicht sich Detektoren täuschen lassen, zeigten Carlini und Farid an fertigen Bildern: Unsichtbare Änderungen genügen, um sie fast vollständig zu täuschen (Carlini und Farid 2020). Ob das bei der Wellen-Textur so wäre, dazu habe ich keine Untersuchung gefunden.
Blau und Michaeli beschrieben 2018 einen Zielkonflikt beim Rekonstruieren von Bildern: Je realistischer ein Ergebnis wirkt, desto weiter weicht es vom Original ab (Blau und Michaeli 2018). Schachbrettmuster gelten seit 2016 als typische Folge des Hochskalierens in neuronalen Netzen und lassen sich eher durch eine andere Bauweise vermeiden als durch mehr Training (Odena et al. 2016; Frank et al. 2020). OpenAIs Architektur ist nicht offengelegt.
OpenAI macht seine Bilder bewusst über C2PA und SynthID erkennbar. Zur sichtbaren Textur gibt es keine offizielle Erklärung. Kurz nach dem Start von gpt-image-2 schrieb ein OpenAI-Forscher, der nach eigener Angabe die GPT-Image-Reihe entwickelt hat, auf X: “Working on fixing this right now”. Worauf sich das bezog, ist unklar. Ich frage mich weiterhin: Warum trainiert OpenAI das nicht weg?
Teil 2 von 2 der Wellen-Textur Serie.